I de dele af de danske farvande, der ved de landsdækkende tællinger optælles fra fly vha. linjetransekttællinger efter Distance Sampling-metoden, kan tætheder og totale antal af udvalgte arter estimeres.
På de store landsdækkende midvinter- og fældefugletællinger dækkes de store åbne havflader efter denne metode. Disse områder omfatter primært de åbne, marine områder, hvor det er praktisk umuligt at opsøge og tælle alle forekommende fugle. Af samme grund anvendes denne linjetransektmetode, som ud fra udsnit i form af forudbestemte transektlinjer, beregner totale antal for relevante arter. Det dækkede areal varierer mellem tællinger alt efter, om tællingen er landsdækkende eller områdespecifik. På de to landsdækkende midvintertællinger i henholdsvis 2020 og 2023 blev der dækket arealer på henholdsvis 37.000km2 og 42.500 km2.
Metoden tager udgangspunkt i, at observatører ikke kan registrere og identificere alle forekommende fugle, og at der er en aftagende sandsynlighed for, at en fugl bliver registreret, med stigende afstand fra flyets rute. Observatøren registrerer alle observationer i én af fire forud definerede afstandsbånd ud fra flyets optællingsrute. Det forudsættes, at observatøren har sit fokus på det transektbånd, der er tættest på flyet, og registrerer alle forekomster af fugle i dette. Efter endt optælling kan en såkaldt detektionsfunktion bestemmes. Den beskriver den faldende sandsynlighed for at se en given fugl med stigende afstand fra flyets optællingsrute, og ved hjælp af den funktion, kan arters eller artsgruppers totale antal og tætheder estimeres.
Optællinger foretaget efter denne metode gennemføres langs forud definerede transektlinjer. De er udlagt over det meste af de danske farvande som parallelle linjer. Start- og slutpunkt på linjerne kan overføres til GPSer, og flyets pilot kan således navigere efter dem på tællingerne. Transekterne er som udgangspunkt udlagt med 5 km interval i de indre danske farvande. Metoden anvendes her til beregning af nationale totale antal af rødstrubet lom/sortstrubet lom, havlit, ederfugl, sortand, fløjlsand, toppet skallesluger, alk/lomvie og mallemuk.
I indeværende rapport for årene 2024-2025 er der lavet rumlig modellering på optællingerne af lommer i Nordsøen (F113 Sydlige Nordsø) og Aalborg Bugt i 2024 (primært F127 Nordvestlige Kattegat, og på de åbne marine områder i F2 og F15 fra Stensnæs i Østvendsyssel til Hevring Bugt ved Djursland), på optælling af mallemukker i Nordsøen (primært F126 Skagerrak) i 2024 og 2025, samt for udvalgte arter på den landsdækkende fældefugletælling i 2025 (F113 Sydlige Nordsø og de indre danske farvande). Metoden til den rumlige modellering er beskrevet herunder.
Beregning af detektionsfunktion
Alle statistiske analyser og modelberegninger er gennemført i R (R Core Team 2025). For hver art eller artsgruppe estimeres en detektionsfunktion på baggrund af fordelingen af observationer mellem afstandsbåndene (Buckland m.fl. 2015). Ud over afstanden til transektlinjen kan sandsynligheden for at registrere en fugl variere som følge af blandt andet observatør, flokstørrelse, fuglenes adfærd samt vejr- og observationsforhold. Der tilpasses derfor en række alternative detektionsmodeller, hvor relevante kovariater indgår enten enkeltvis eller i kombination.
Modellerne sammenlignes ved hjælp af Bayesian Information Criterion (BIC), som afvejer modellens tilpasning til data mod antallet af estimerede parametre. Den model, der på denne baggrund vurderes at give den bedste beskrivelse af detektionssandsynligheden, anvendes efterfølgende til at korrigere de observerede antal for ufuldstændig detektion og til at beregne et detektionskorrigeret antal fugle for hvert transektsegment (alle fløjne transekter skæres op i segmenter af 500 meters længde). Disse korrigerede antal danner grundlag for den efterfølgende modellering af fuglenes antal og deres rumlige fordeling.
Rumlig modellering
Da linjetransekterne kun udgør et udsnit af det samlede undersøgelsesområde, anvendes rumlig modellering til at estimere fuglenes forekomst i de områder mellem transekterne, som ikke er optalt. De detektionskorrigerede antal modelleres ved hjælp af rumligt adaptive regressionsmodeller (SALSA) i R-pakken MRSea (Scott-Hayward m.fl. 2023). SALSA er en fleksibel regressionsmetode, hvor graden af udglatning kan variere rumligt, og dermed tilpasses heterogeniteten i fuglenes geografiske fordeling (Scott-Hayward m.fl. 2014).
Der opstilles en række kandidatmodeller, hvor fuglenes forekomst modelleres i forhold til vanddybde, afstand til kysten og geografisk placering. Herved kan modellen tage højde for, at fuglenes forekomst både varierer med de undersøgte miljøforhold og geografisk inden for undersøgelsesområdet. Den endelige model udvælges ved femfold krydsvalidering på transektniveau, hvor kandidatmodellernes evne til at forudsige forekomsten på transekter, der ikke indgår i modeltilpasningen, sammenlignes. Dette reducerer risikoen for overtilpasning, og giver et mål for, hvor godt modellerne kan beskrive fuglenes fordeling uden for de data, de er tilpasset.
Den valgte model anvendes herefter til at beregne det forventede antal fugle i et gitter med 500 × 500 m celler inden for det undersøgte område. Ved at summere de beregnede antal på tværs af gittercellerne kan det samlede antal fugle i området estimeres, samtidig med at modellen giver et detaljeret billede af deres geografiske fordeling.
Usikkerheden i estimaterne kvantificeres ved hjælp af en bootstrap-procedure med 500 gentagelser. For hver gentagelse indarbejdes variation i den estimerede detektionsfunktion, hvorefter det detektionskorrigerede antal genberegnes, og den valgte rumlige model tilpasses igen. Bootstrap-proceduren viderefører dermed usikkerheden fra detektionsanalysen til den rumlige modellering. Variationen mellem gentagelserne anvendes derefter til beregning af 95% konfidensintervaller for de estimerede antal.
For arter eller tællinger med et begrænset antal observationer er datagrundlaget utilstrækkeligt til at estimere en robust rumlig model. I disse tilfælde anvendes i stedet et designbaseret estimat, hvor den detektionskorrigerede tæthed i de optalte transektsegmenter opskaleres til det samlede undersøgelsesområde.
Estimater af totale antal
I den seneste NOVANA-rapport (2022-23) blev der ikke foretaget rumlig modellering af data indsamlet efter metoden for linjetransekttællinger. Her blev der udelukkende estimeret totale antal. Metoden og beregningen af de estimerede totale antal fra de landsdækkende midvintertællinger i 2020 og 2023, lomtællingen i Aalborg Bugt i 2022, samt optællingen af mallemukker i august 2022 beskrives i detaljer af Buckland m.fl. (2015), og beregningerne er foretaget i R (R Core Team 2022) vha. metoden/scripts beskrevet af Miller m.fl. (2019).
For hver art laves der en opgørelse over, hvor mange observationer den enkelte observatør har. Observatører der har under 2% af observationerne for den givne art filtreres fra. Dette gøres for at undgå for store forskelle i observatørbias samt for at mindske de statistiske frihedsgrader for den beregnede detektionsfunktion. Efterfølgende beregnes en række forskellige detektionsfunktioner, hvori der kan indgå følgende kovariable: observatør, flokstørrelse, seastate (bølgehøjde) og/eller fuglenes adfærd. De forskellige modeller/funktioner vægtes op mod hinanden ved at beregne Akaike Information Criteria (AIC), hvor den laveste AIC værdi typisk repræsenterer funktionen med den mindste usikkerhed og dermed også den funktion, der vælges til at beregne det samlede antalsestimat.
Til sidst plottes detektionsfunktionerne med tilhørende beregnede estimater for arten. Desuden angives et konfidensinterval med en nedre grænse (benævnt LCL) og en øvre grænse (UCL), der beskriver den statistiske usikkerhed, der er på det beregnede estimat.
R Core Team (2025). R: A Language and Environment for Statistical Computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org.
Scott-Hayward, L. A., Mackenzie, M. L., & Walker, C. G. (2023). MRSea R package (V1.5.0): spatially adaptive uni and bi-variate regression splines using SALSA.
Scott-Hayward, L. A., Mackenzie, M. L., Donovan, C. R., Walker, C. G., & Ashe, E. (2014). Complex Region Spatial Smoother (CReSS). Journal of Computational and Graphical Statistics, 23(2), 340-360.
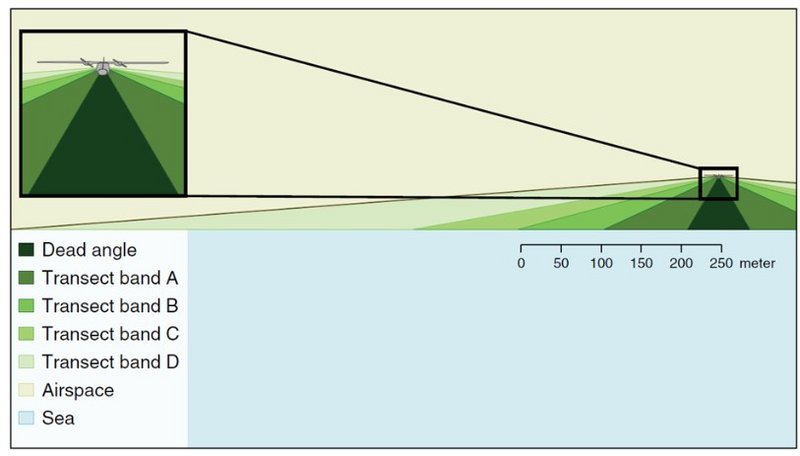
Figur 1. Definition af de fire afstandskategorier, som de registrerede fugle inddeles i på en transekttælling. Bånd A svarer til 44 – 119 meter; Bånd B svarer til 119 – 388 meter; Bånd C svarer til 388 – 956 meter og bånd D svarer til afstande større end 956 meter. Der er en blind vinkel under flyet, hvor observatørerne ikke kan se fuglene, svarende til 0 – 44 meter.
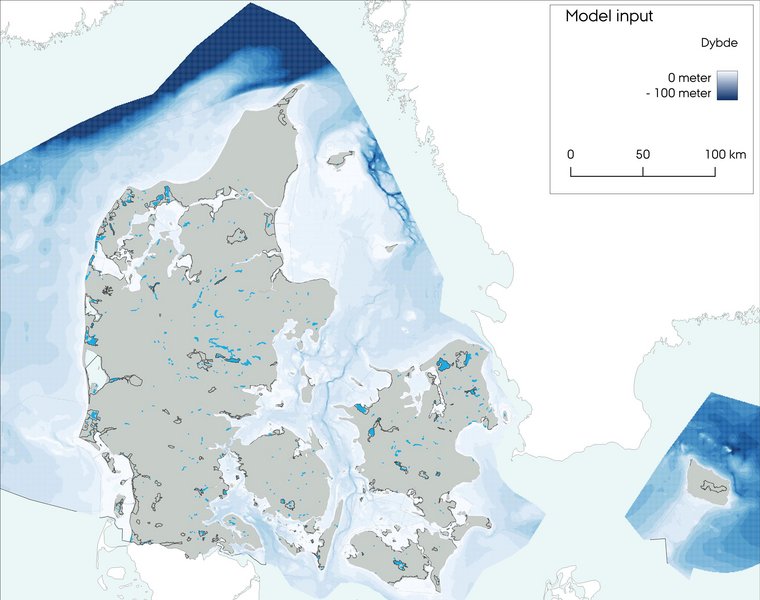
Figur 2. kort over vanddybde, som er en af inputparametrene til den rumlige model.
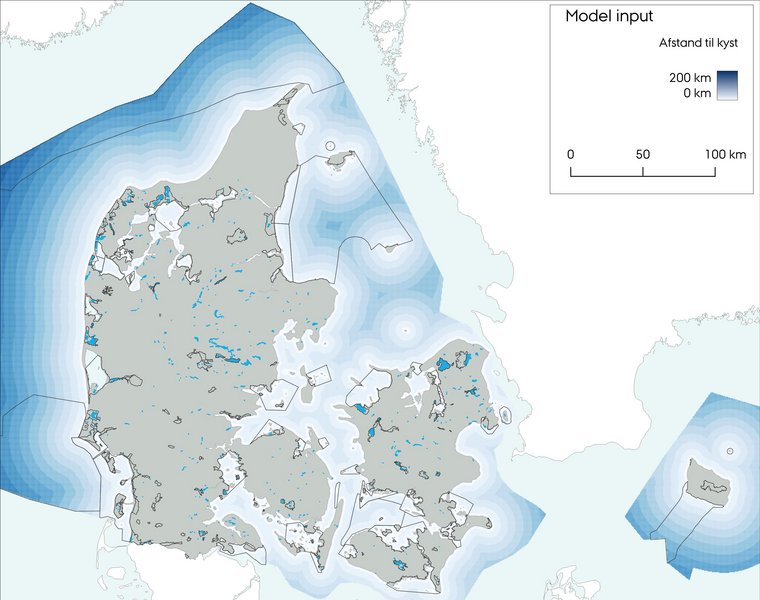
Figur 3. kort over afstand til kyst, som er en af inputparametrene til den rumlige model.

